10 月 19 日,DeepSeek V4.1 Flash 1017 在 Artificial Analysis 上是 45 分,開放權重第二。11 月 2 日,同一顆模型在榜上是 29 分(high),max 則是 32.5。
權重沒換,checkpoint 沒動。變的是尺。
10 月 27 日 AA 發布 Intelligence Index v5,官方講得很白:v5 的分數跟 v4.3、v4.3.2 是不同尺度,不能互相比。所以 45 到 29 是重算,不是退步。剩下的問題只有一個:新尺量的是什麼,為什麼它掉得比別人多。
新尺量的是「做完」,不是「答對」
v5 用九個評測,切成四塊各佔 25%。知識工作是 AA-Briefcase 15%、AutomationBench-AA 5%、GDP.pdf 5%;程式是 FrontierCode 2.0 15%、Terminal-Bench 4.0 10%;科學是 Terminal-Bench-Science 15%、CritPt v2 硬子集 10%;一般知識是 AA-Omniscience v1.1 15%、HLE-Diamond 10%。
同時砍掉三項:GDPval-AA v2.1、SciCode、AA-LCR v1.1。
兩個數字說明方向。私測集或保留答案的比例從 45% 拉到 60%,考題藏在開發者看不到的地方。每題輸出 token 的中位數從三萬五千顆跳到五萬九千顆,多了三分之二,因為題目要模型自己動手、反覆試。
答對一題,變成一題做完。這是 v5 唯一需要記住的一句話。
它掉在兩科,而那兩科佔 25% 權重
Terminal-Bench-Science 是七十個專家設計與審核的研究流程任務,在終端機裡跑,一題裡任何一個測試沒過就是零分。GPT-6 Astra 63%、Opus 5.5 59%、Sol 58%。Kimi K3.1 Pro 34%,是開源最高的。DeepSeek 1017 是 13%,而多數被測的開源模型低於 10%。
FrontierCode 2.0 是 Cognition 的私測,132 個真實開源 repo 的任務,評分標準是維護者會不會 merge 你的改動,每題跑三次。Opus 5.5 46% 領先,DeepSeek 1017 是 28%,開源裡最高,落後 18 分。
兩科合計 25% 的權重,它只拿到四分之一。而它原本拿分的 SciCode 與 GDPval 已經不在考卷上。
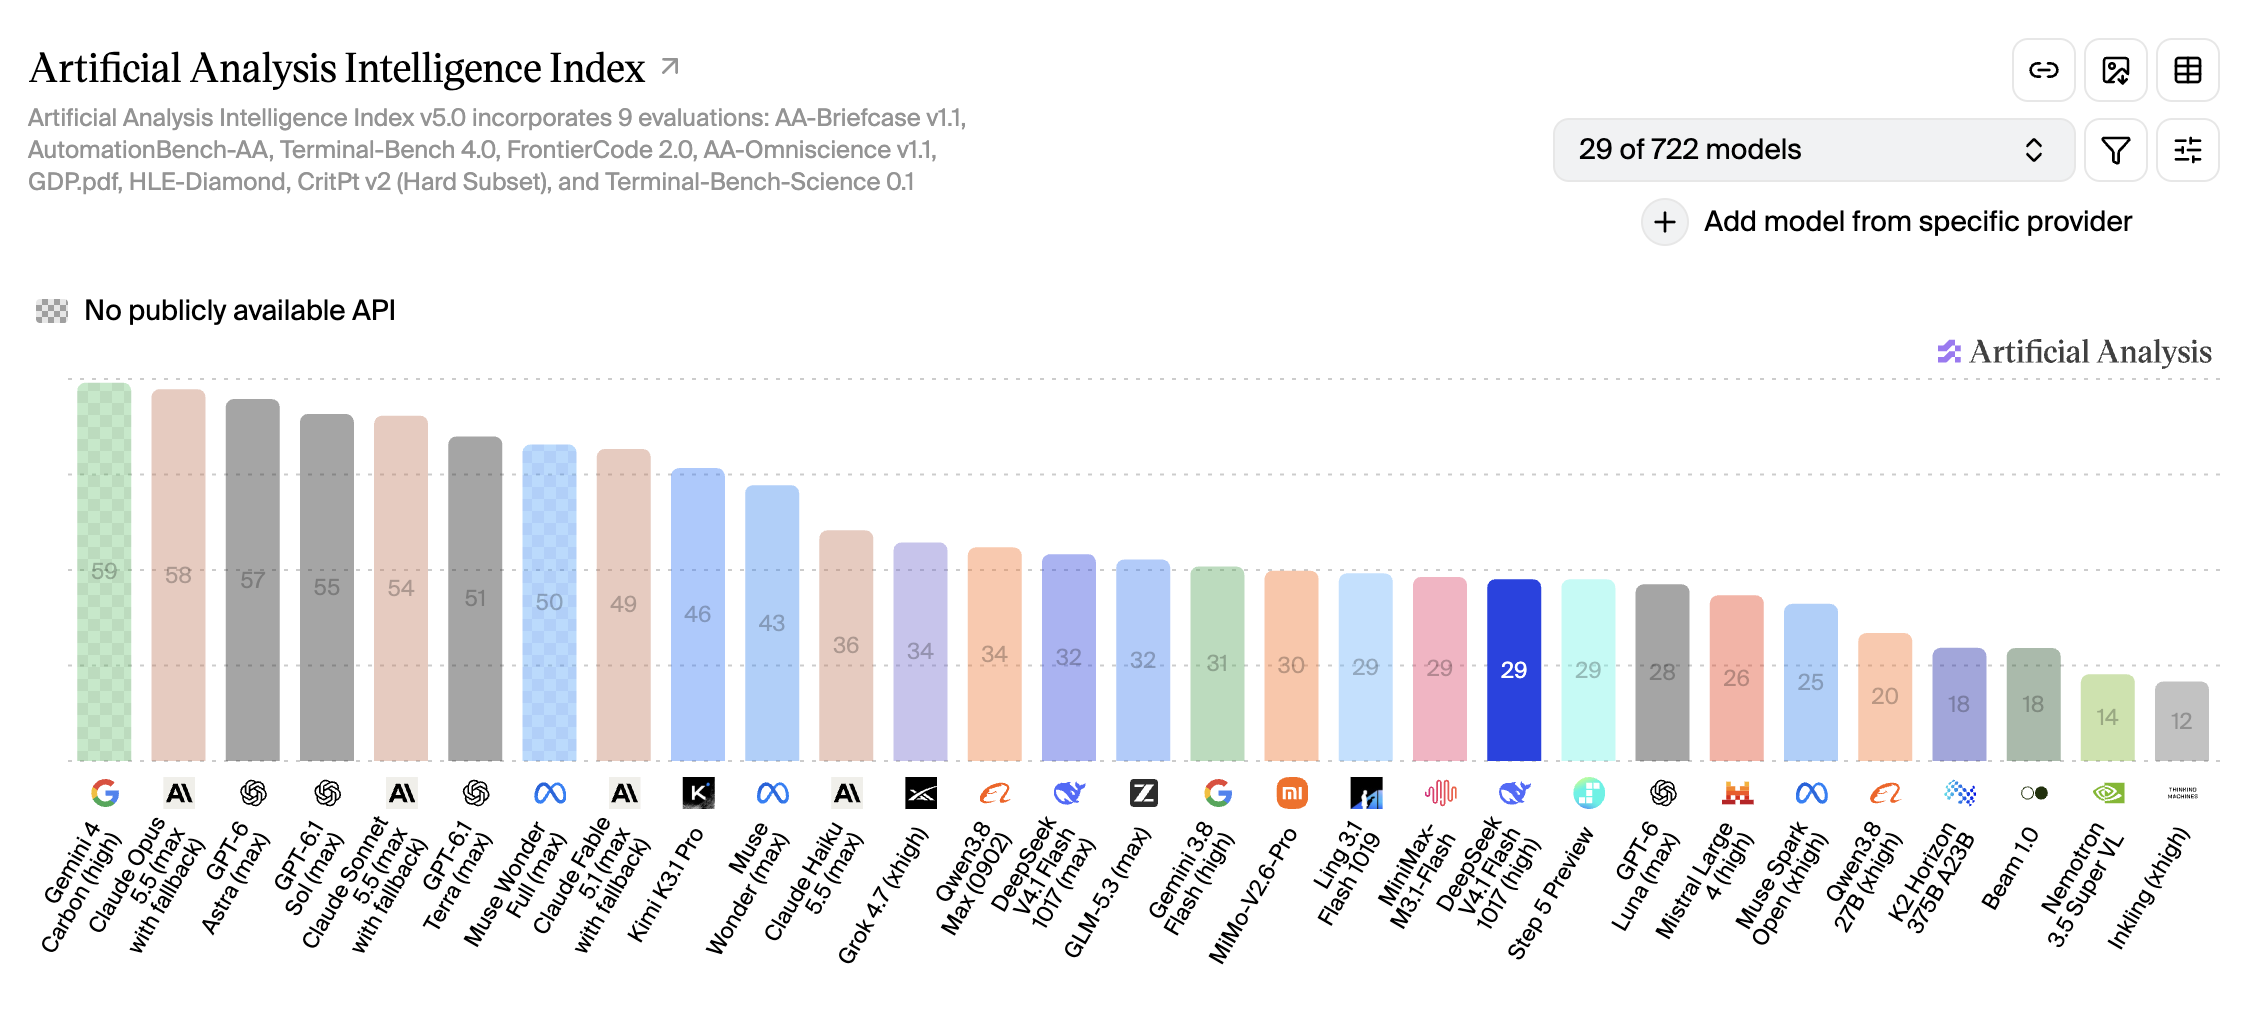
同一段時間,Carbon 從 59 到 59.4,幾乎沒動;Kimi 從 55 掉到 46。差距就是這樣拉開的。v4.3 時代閉源與開源差 3 分,v5 是 12 分。
廠商表上的 42.3 分也沒有錯
DeepSeek 自家 changelog 寫著,1017 的 Terminal-Bench 4.0 是 42.3%,九月版是 31.2%。這個數字是真的,只是量的東西不同。
它跑在 Claude Code 的框架裡,AA 用自家的 Stirrup。它報的是單一考卷,AA 給的是九張考卷的加權平均,其中一張 FrontierCode 2.0 它沒考過。
所以 42.3 和 29 可以同時成立。一個是「這張考卷我考幾分」,一個是「你要的九張裡我平均幾分」。
對實際使用意味著什麼
先看它到底能不能用。10 月 19 日那篇海洋的 25KB 單檔,512×512 FFT 海面、18 個 compute dispatch、60 fps,就是這顆模型寫的,494 次呼叫、77.5 萬輸出 token。那是單一任務、長輸出、工具用得少,正好是它還站得住的地方。
要它自己跑多步、自己驗證、自己修,29 分會露出來。
解法兩個:把 effort 拉到 max(32.5 分),或換手。
Carbon 59.4 一題 7.76 美元,Kimi 46 分一題 3.68 美元,1017 一題 0.60 美元。
價格要看人民幣原價。
Flash 每百萬 token:快取命中 0.02 元(空閒)與 0.04 元(高峰),未命中 1 元與 2 元,輸出 4 元與 8 元。
北京時間週一到週五 9 到 12 點、14 到 18 點算高峰,其餘時段與週末半價。
Search 與 Fetch 是另外兩支 API,每 1,000 次成功請求各 5 元,11 月 1 日起對 Harness、Claude Code、Codex 裡的 server 端呼叫收費。
還有一個同一家內部的對照:V4 Pro 0813 在榜上是 23 分,比 Flash 1017 的 32 分低 9 分,每題 1.77 美元、速度 94 token/s、併發上限 500、不支援圖像。
旗艦停在八月,分數、價錢、速度三樣都輸給副將。
結論
45 到 29 不是能力掉了,是考卷換了:從答得對改成做得完,私測比例從 45% 拉到 60%,每題工作量多了三分之二。
它掉在兩科:Terminal-Bench-Science 13%、FrontierCode 2.0 28%,合計 25% 權重;被砍掉的三科原本是它的強項。掉 12.5 分是結構造成的。
用法要對上分數:單一長輸出它夠用,一題 0.60 美元;多步自我驗證就換 max 或換手,成本三到十三倍。分數是別人的考卷,帳單是自己的。
排行榜每換一次尺就熱鬧一次。熱鬧的是名次,不變的是那條線:能不能自己動手把事做完。v5 把這條線量出來了,量出來的結果對小模型不太好看,對你的帳單倒是很清楚。
౨ৎ Anthony 不負責任編輯 ~
留言 (0)