Artificial Analysis v4.3 給 40 分(同級開源大模型第 6)、速度 190 tok/s(第 4),而每 1 分的實付成本只有 GLM-5.3-Flash 的一半。這不是價格戰,是架構戰——官方把 KV cache 壓到上一代的 1/4,省下來的成本才傳給用戶。
有個朋友昨天問我:「愛馬仕要用哪個模型?」
我講了一句話,他半信半疑:用 deepseek-flash,不要用 pro。
今天 Artificial Analysis 的 v4.3 分數出來,那句話有實測撐了——40 分,同級開源大模型裡第 6。
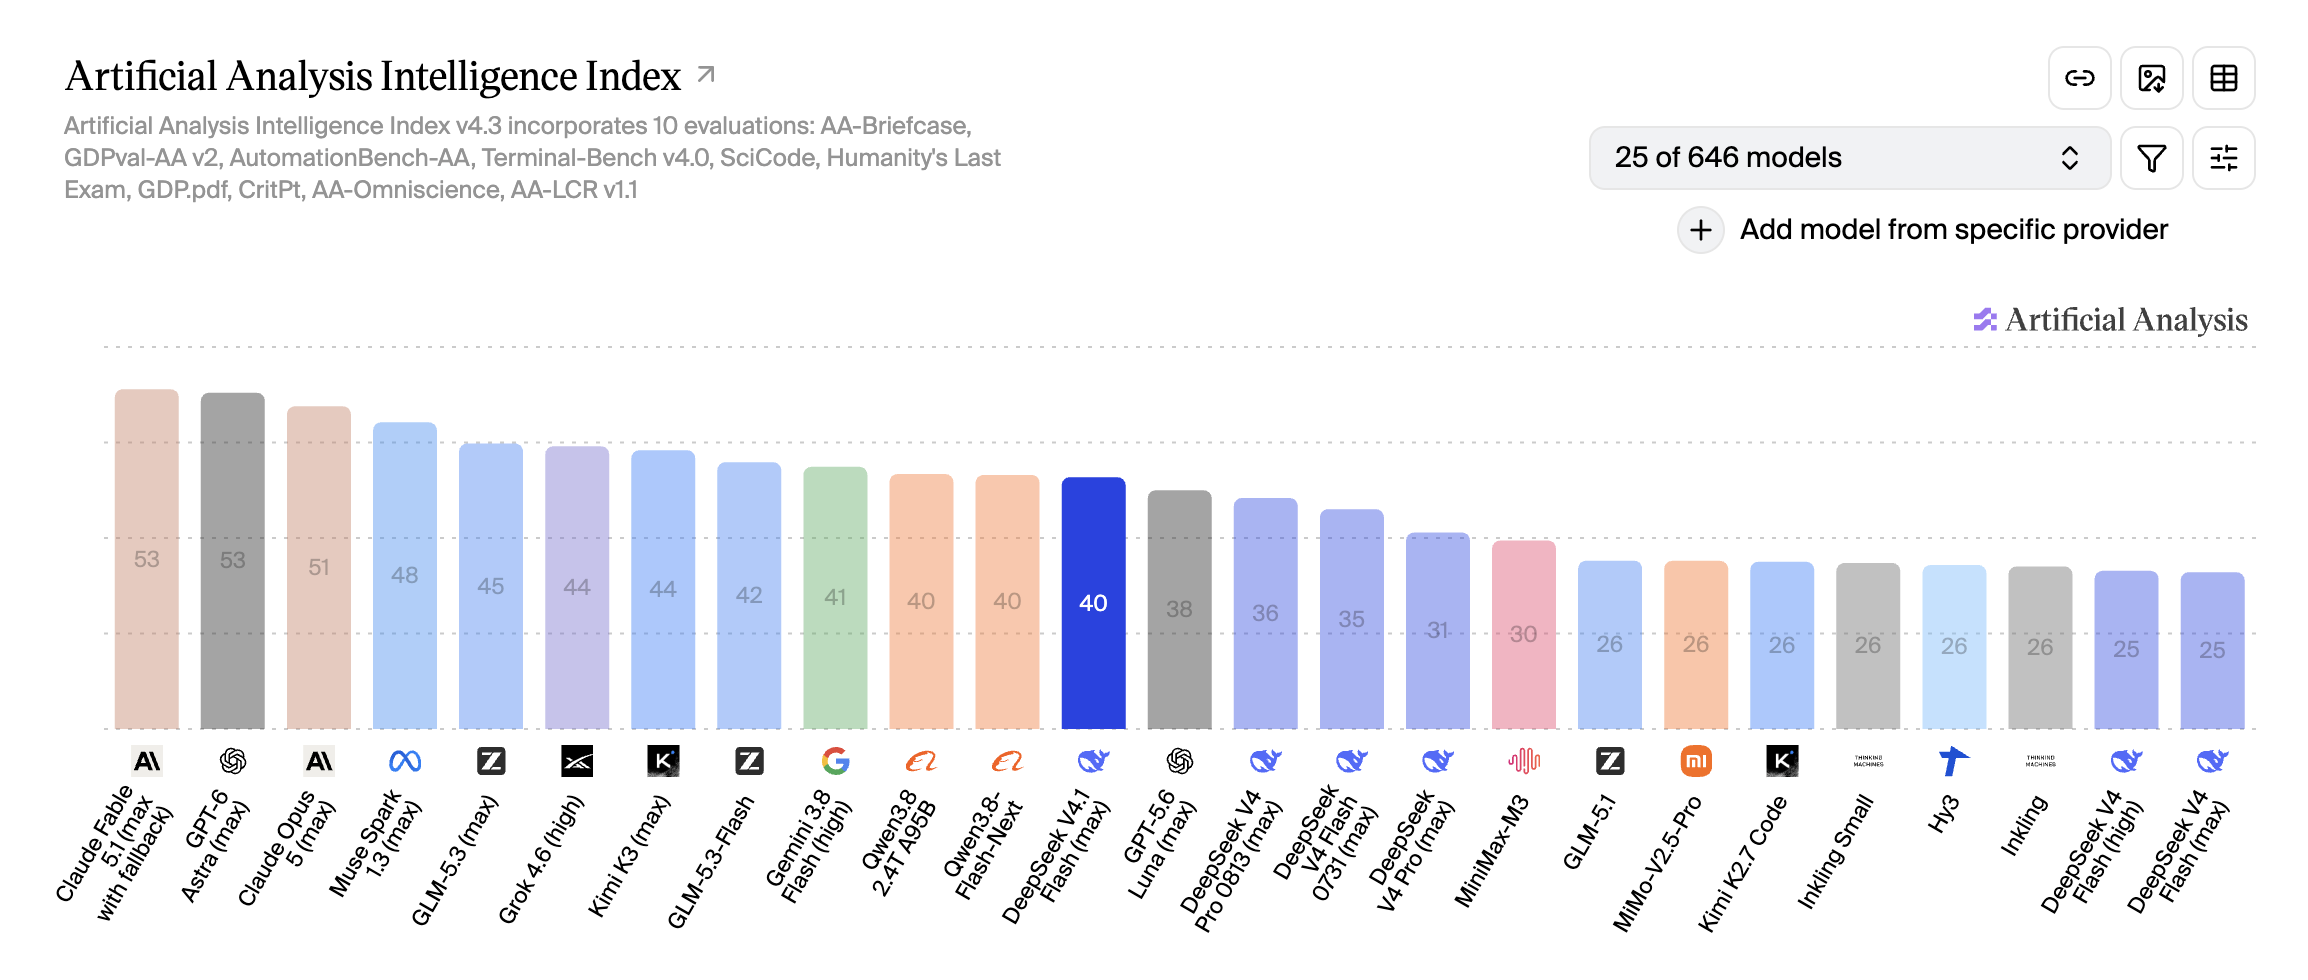
Artificial Analysis Intelligence Index v4.3,前 25 名模型。資料來源:Artificial Analysis(2026-09-11 擷取)
AA v4.3 實測:40 分
模型 | 分數 | $/task |
|---|---|---|
GPT-6 Astra (max) | 53 | 3.26 |
GLM-5.3 (max) | 45 | — |
GLM-5.3-Flash | 42 | 0.25 |
Gemini 3.8 Flash (high) | 41 | — |
Qwen3.8 2.4T A95B | 40 | — |
DeepSeek V4.1 Flash (max) | 40 | 0.27 |
GPT-5.6 Luna (max) | 38 | 0.18 |
DeepSeek V4 Pro 0813 | 36 | — |
DeepSeek V4 Flash 0731 | 35 | 0.22 |
同一個尺上:比上一代 V4 Flash 高 5 分,比 V4 Pro 高 4 分。
而且那個「Pro 比較強」的印象正式被推翻——DeepSeek 自己在公告裡寫得很直白:多方測試顯示 V4.1 Flash 在效能、成本、速度、總用時全面超越 V4 Pro,所以 Pro 要下線。9 月 14 日 04:00 UTC 起,所有打到 deepseek-v4-pro 的請求會全部改路由到 V4.1 Flash、按 Flash 計費。
速度:榜上第 4
tok/s | |
|---|---|
DeepSeek V4 Flash 0731 | 127.8 |
DeepSeek V4.1 Flash | 190.1 |
快 48.7%,排在同級第 4。
速度在 chat 只是體感,在 agent 是生死。一個任務十幾步工具呼叫,每一步多兩秒,整趟就差好幾分鐘。這也就是為什麼我上週試了另一家的 agent 工具,功能清單一模一樣,卻用不下去——查個模型都要等很久。
帳單:牌價 vs 實付
AA 算出來的 $0.27/task 是用官方牌價 $0.30 / $1.20 去算的。
但真正的帳單要看你的排程。V4.1 Flash 是峰谷定價,離峰是高峰的一半,而高峰只有北京時間週一到週五 9–12、14–18——把排程排在深夜跟假日,就是直接打五折。
分數 | $/task | 每 1 分的成本 | |
|---|---|---|---|
GLM-5.3-Flash | 42 | 0.25 | $0.0060 |
DeepSeek V4.1 Flash(實付、全離峰) | 40 | 0.127 | $0.0032 |
帳面上 GLM 高 2 分;實付上你便宜一倍。同樣的錢,買到的分數是兩倍。
換成我習慣的台幣口徑(月 10 億 token、95% 快取命中、匯率 4.71):9/10 新價的月帳是 NT$4,028——這是同一份價格,我上次算過的那筆帳。
為什麼能降價:KV cache 縮到 1/4
這是我覺得整件事最被低估的部分。降價公告大家都會寫,但官方為什麼敢降寫在 Hugging Face 的模型卡裡,而且標題自己就講了:*Pushing the Limits of KV Cache Compression*。
技術細節(全部可查證):
552B MoE,但每個 token 只啟用 16B。新的 Causal Encoder-Decoder 架構是 20 層 encoder 接 20 層 decoder,decoder 的全域 KV cache 直接從 encoder 的最終輸出投影出來——所以 prefill 只啟用 8B、decode 16B
KV cache 890 bytes/token,約上一代的 1/4。用 FP4(4-bit) 存 KV cache
SWA Bounded Replay 讓持久 KV 不必寫進 SSD,footprint 再降到 1/8
45T tokens 從零訓練,MIT 授權,1M context,原生吃圖
帳單的祕密在最後一項:agent 的成本大頭是 cache hit。我自己的結構是 95–99% 命中。所以「把 cache 縮到 1/4」不是省自家硬碟,是直接動到 agent 用戶帳單裡最大那一欄——然後把省下來的傳出來。
這才是這次降價的性質:不是促銷,是成本結構變了。
愛馬仕要用哪個模型
回到我朋友那個問題。我的答案:
1. 模型名寫 deepseek-flash。舊的 deepseek-v4-flash、deepseek-v4-flash-vision-exp 只是「暫時路由」,官方原文寫得很清楚是為了相容——不要寫進新設定 2. 不要寫 deepseek-v4-pro。9/14 之前它還是真的 Pro(貴 3.4 倍),9/14 之後才開始路由 3. vision 不用另外設。V4.1 Flash 原生多模態,截圖讀表格直接丟就好 4. reasoning_effort 只吃字串。我實測:"high"、"max" 都回 200,寫整數 50 會回 400(官方講的「1–100 可調」不是這個參數名)。所以現有設定不用改
順帶一個好消息:這一版同一顆模型還能開圖——AA 的規格表寫 input modality 是 text and image。之前 vision 得另外掛一個實驗模型,現在主模型自己就會。
兩個要注意的缺點
誠實講:
囉唆。AA 量到它跑完一輪測試吐了 250M tokens,中位數只有 130M——接近兩倍。輸出是帳單主導項,所以實際帳單會比帳面高三成以上(GLM、Qwen 都有同一個毛病)
只有 1 個 provider。就是 DeepSeek 官方自己,沒有第三方代管。它掛掉就是真的斷,不像別的模型有十幾家可以繞
結論
DeepSeek V4.1 Flash:Artificial Analysis v4.3 實測 40 分(同級開源大模型第 6),比上一代 Flash 高 5 分、比 V4 Pro 高 4 分
速度 190.1 tok/s(同級第 4),比上一代快 48.7%;降價的原因是官方把 KV cache 壓到 1/4(FP4 儲存、持久 footprint 1/8),不是促銷
實付成本:全離峰 $0.127/task,每 1 分的成本是 GLM-5.3-Flash 的一半;模型名寫
deepseek-flash,舊名只是暫時路由
價格戰會停,架構戰不會——這次降的不是價格,是 KV cache 的體積。
౨ৎ Anthony 不負責任編輯 ~
留言 (0)