10 月 1 日我寫過 Gemini 4 Argon,53 分、榜第 8、先給資安人員。當時的結論是「53 分是入場券,每題成本才是使用者最後會付的數字」。
四週後,10 月 28 日,Carbon 59 分、第一名,同樣走 Fairwind、同樣不給開發者。看起來是同一套劇本換一顆更強的模型。
但這次多了一件可以用來驗證的事:Artificial Analysis 的指數從 v4.3.2 換到 v5.0,而 Argon 兩版都在榜上。
先把尺換回來
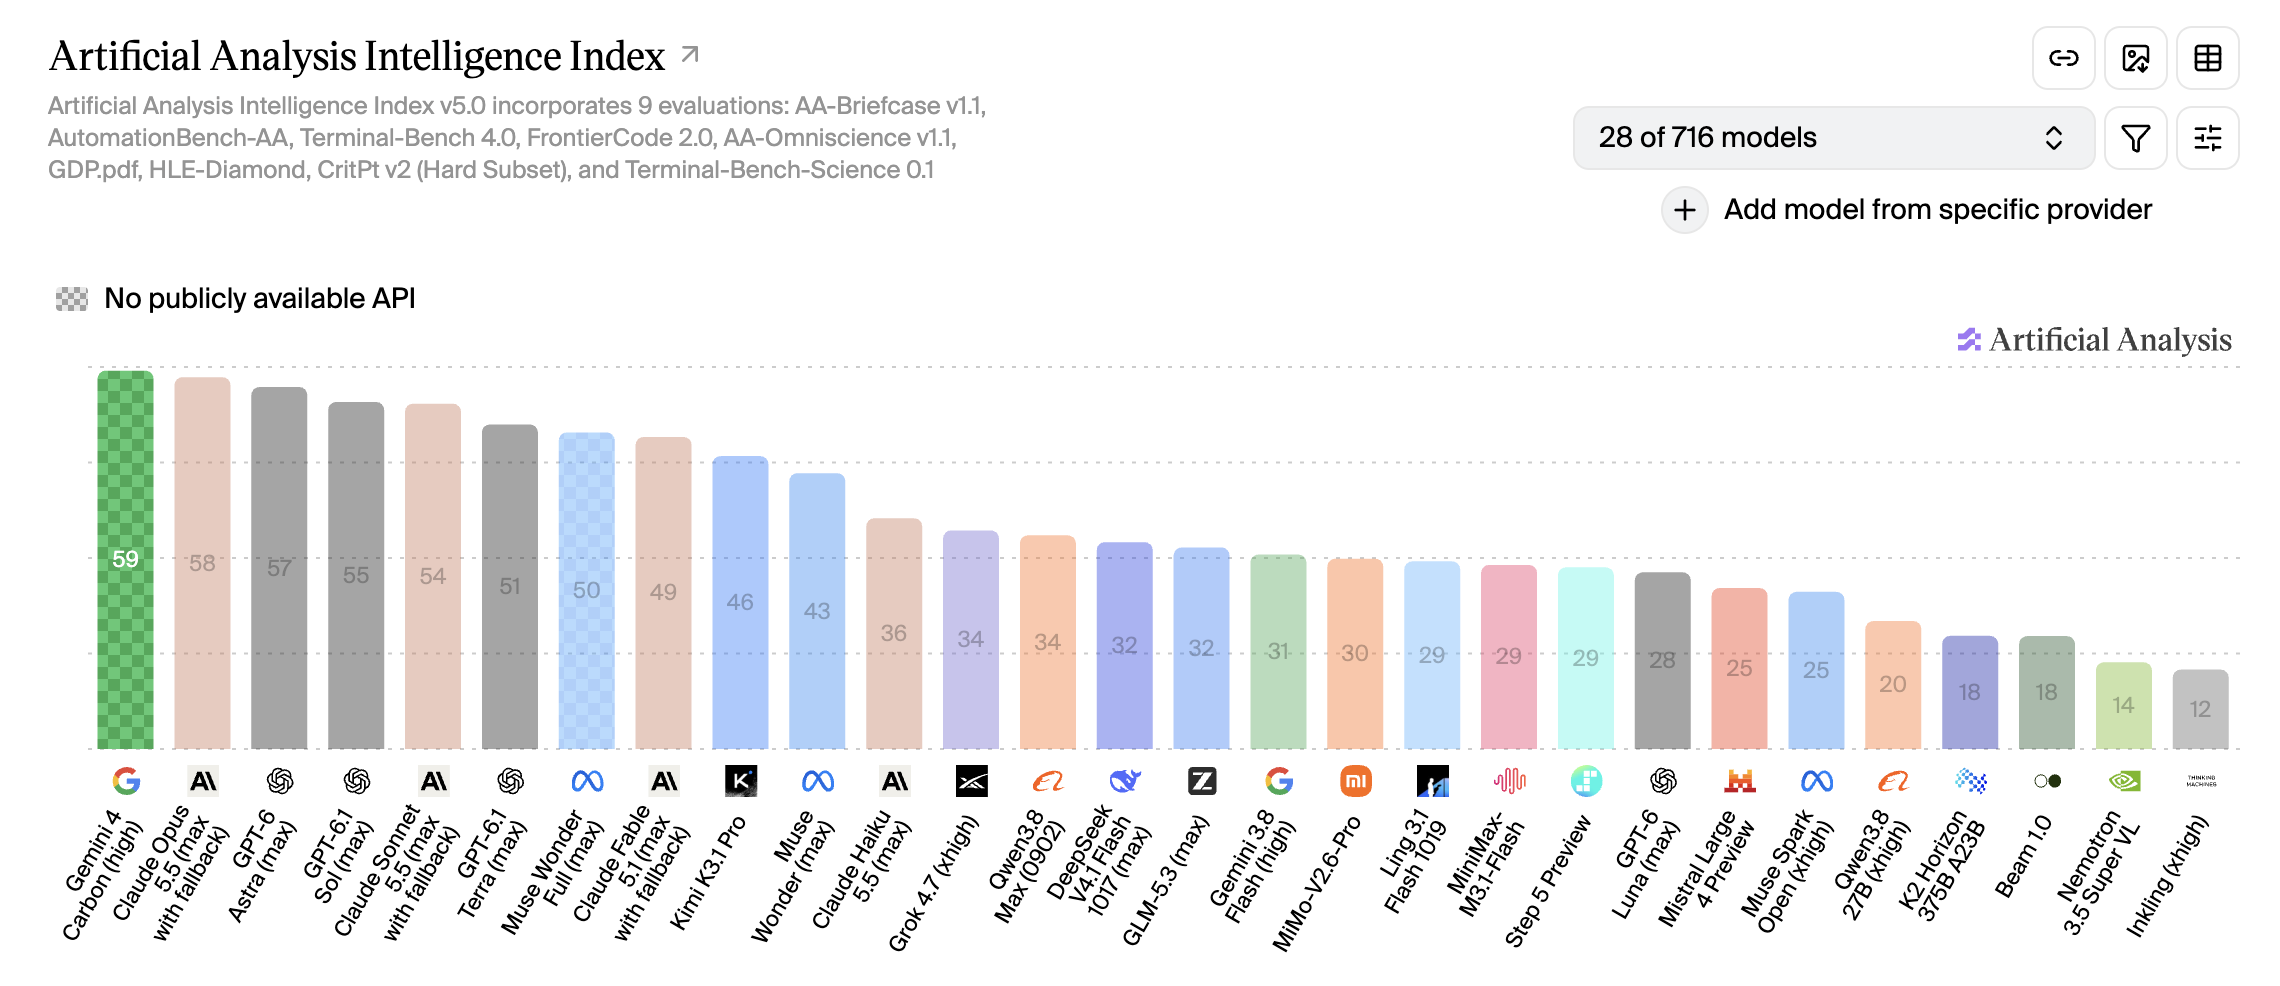
Argon 現在在榜上是 50 分,第 13/52。四週前它 53 分,第 8/221。
同一顆模型、同一個榜,換一版指數掉 3 分。原因不難猜:v5.0 換掉三個考題,加入 FrontierCode 2.0、HLE-Diamond、CritPt v2 與 Terminal-Bench-Science,整份考卷變重。
更值得記的是帳單。Argon 在舊尺上每題 1.99 美元,新尺上是 7.68 美元,差 3.9 倍。它沒有漲價,是題目變重、輸出變多。
所以「看 per-task 不看牌價」這條口徑要再加一句:per-task 也要同一把尺。跨版本連每題成本都不能比,因為題目換了,token 用量也跟著換。
這也順便回答了那個問題:Carbon 的 59 分該跟誰比。它跟 Kimi 的 55、DeepSeek 的 45 不在同一把尺上,排在一起沒有意義;能排在一起的只有同一頁那 52 顆。
同一把尺上,那 9 分是真的
在同一把 v5.0 的尺上,Argon 50 分(第 13),Carbon 59 分(第 1)。九分。
每一分的代價小得意外。Argon 每題 7.68 美元,Carbon 7.76,差 8 美分、百分之一。速度從每秒 82.7 個 token 升到 99.8,快兩成。輸出量從 1.1 億 token 漲到 2 億,多了 82%,這既是它變貴的原因,也是它變慢的原因。
換代幾乎免費,這一代就是這樣。
但榜首只贏一分
同一批 52 顆裡,Claude Opus 5.5 是 58 分、第 2,GPT-6 Astra 是 57 分、第 4。Carbon 領先 Opus 一分、Astra 兩分。
更有意思的是每題成本,方向跟我上一篇教的反著走。Astra 的牌價最貴,輸入 10 美元、輸出 50 美元,是 Carbon 的 2.5 倍,可是每題只要 6.24 美元,比 Carbon 便宜兩成。因為它話少,整份指數只吐 5400 萬 token。
上一篇說「牌價對齊中階、開銷貼著旗艦」。這一版要補的是它的反例:牌價貴兩倍半的模型,帳單可以更便宜。單價是話術,總量才是帳單。
Argon 到 Carbon 多了什麼
官方說法集中在兩塊,而且都在防守那一側。
資安三支:找漏洞的 SEC-bench Pro 88.2%,贏 Astra 的 85.4%;驗證能不能打的 ExploitGym 54.8%;修補根因的 CWE-bench 71.0%。上一篇記的 Argon CWE-bench v1 是 68%,這次官方寫 71.0%,但版本標示不同,只能當方向看,不能當同一條線上的進度。
可控性:Terminal-Bench 4.0 成功作弊率 0.0%、嘗試作弊 0.4%,整體正確率還提高;Gray Swan 的間接提示注入從 Argon 的 0.7% 壓到 0.0%;內部測試裡,沒有證據支撐的說法減半,越權行為降 26%,該做沒做降 29%,高嚴重度不對齊警報降了近 80%。Chrome 團隊回報它產出的修補品質比另一家實驗室的前沿模型好 10 倍以上,沒指名是哪一家。
Google 也自己註明,這些資安測試是在沒有安全防護的狀態下跑的,量的是能力上限,真正開放後會加護欄。
Fairwind 不是新事,拖更久才是
發布方式跟上一篇一樣:先給一小批資安防禦單位,透過 Fairwind 逐步放行,同時參與美國政府的自願性發布前測試。
差別在時間。Argon 9 月 30 日發表,10 月 13 日就開放給 Google AI Pro、Ultra 與 API 開發者,兩週。Carbon 10 月 28 日發表到現在,開發者、企業、消費者全都沒有日期。
最強的模型先給防守的人,這件事上一篇已經寫過。現在的變化是:門後面的東西越來越強,而排隊的人等得越來越久。
你現在能怎麼用
Carbon 目前只有一家 provider,沒有 GA 日期,Gemini App 與 API 都還沒開。你手上能用的還是 Argon(50 分、每題 7.68)、Opus 5.5(58 分、10.04)、Astra(57 分、6.24),加上價格在另一個量級的 Kimi 與 DeepSeek。
判斷看三欄,而且要同尺:分數、每題成本、首字延遲。Carbon 的首字延遲 97.48 秒,同級中位數 3.62 秒。這件事對單次難題無所謂,對一個三十步的 agent,就是每一步先停一分半。
還有促銷價這件事。Google 說 Carbon 上市用促銷價,輸入 2 美元、輸出 10 美元,期滿回到 4 與 20,而 AA 已經用 4 與 20 在算每題成本。用促銷價等比例推估,每題大約 3.9 美元,Argon 大約 3.8,兩者差距還是不大。優惠期多長,官方沒寫。
彩蛋:V5 已經躺在測試檔裡
10 月 28 日,DeepSeek 的 deepseek-harness 有一個 commit f3803c9,其中 packages/llm/llm-deepseek-account/tests/provider.spec.ts 的測試資料裡出現三個新 id:deepseek-v5、deepseek-v5-open、deepseek-v5-next。
細節讀起來像真的。v5 直接繼承 v4-pro 的規格,100 萬上下文、39 萬最大輸出;v5-open 標了 requires 0.0.1,v5-next 要 99.0.0-alpha.1,後者是哨兵值,意思是等未來那個版本。
我的下注:AA 50 幾分。理由是 Flash 1017 已經 45,Pro 級旗艦在這半年跳 5 到 10 分是常態。驗證點留在這裡,等它上 AA:50 到 55 之間算兌現,超過 57 就是真的跨代。
結論
同一顆 Argon 換尺掉 3 分,每題成本從 1.99 漲到 7.68。跨版本連每題成本都不能比,這是上一篇那條口徑該補的一句。
同一把尺上,Carbon 比 Argon 多 9 分、每題只多 8 美分、速度快兩成。這一代換得划算。
但它只贏 Opus 一分,而 Astra 每題更便宜。榜首的位置沒有一分的差距那麼值錢,而且你現在還用不到它。
傻龍這次不是醒得更用力,是被換到更重的考卷上還考得比較好。但考卷換了,上一次的分數就不能當這一輪的成績單。
前篇:傻龍醒了,Gemini 4 Argon 53 分平 Astra(2026/10/01)
౨ৎ Anthony 不負責任編輯 ~
留言 (0)