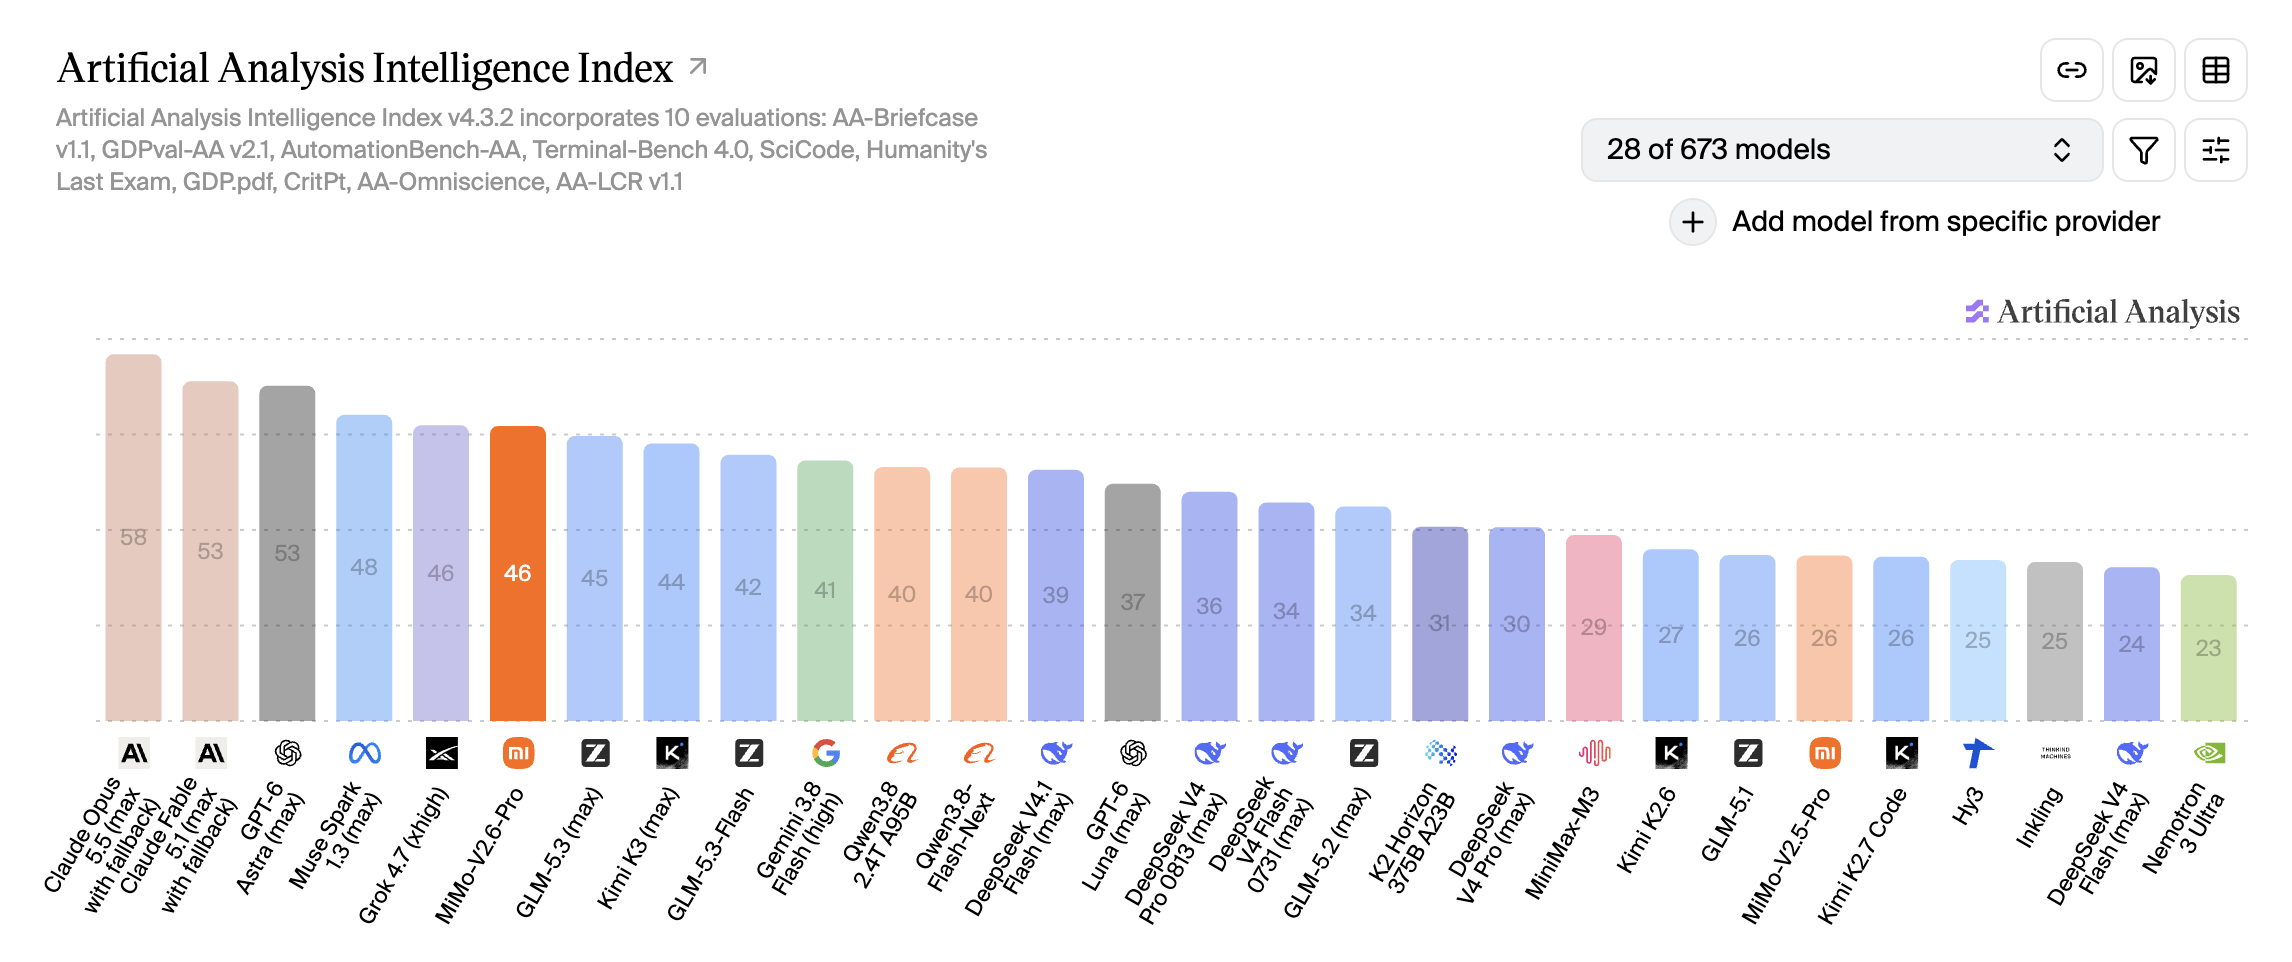
同一個早上,兩家發佈自家新模型:小米 MiMo V2.6、xAI Grok 4.7。
第三方評測 Artificial Analysis 給 MiMo V2.6 Pro 的分數跟 Grok 4.7 一模一樣:都是 46 分(v4.3.2 尺)。
差別在價格:一顆每題 0.13 美元,另一顆 3.74 美元。
(先講清楚:AA 現在只收錄了 Pro,/models/mimo-v2-6-flash 是 404,Flash 這顆沒有任何第三方分數。
所以下面所有「46 分」都是 Pro;我自己跑的是 Flash,更便宜的那一顆。)
29 倍。
現在我自己把主模型切到 MiMo V2.6 上跑,把兩邊的官方價目逐格核過一遍,最後拿一次真實的大型工程(下面那段實測)驗帳單。結論先講:你付的錢買的不是智商。
官方價目(一手,人民幣/百萬 tokens)
模型與情境 | 快取命中 | 未命中輸入 | 輸出 | 同用量合計 |
|---|---|---|---|---|
MiMo V2.6 Flash 實時 | ¥0.02 | ¥1 | ¥2 | ¥3.18 |
MiMo V2.6 Flash 批量 | ¥0.01 | ¥0.5 | ¥1 | ¥1.59 |
MiMo V2.6 Pro 實時 | ¥0.025 | ¥3 | ¥6 | ¥9.23 |
MiMo V2.6 Pro-UltraSpeed 實時 | ¥0.25 | ¥30 | ¥60 | ¥92.3 |
DeepSeek V4.1 Flash 離峰 | ¥0.021 | ¥1.04 | ¥4.14 | ¥5.36 |
DeepSeek V4.1 Flash 尖峰 | ¥0.041 | ¥2.07 | ¥8.28 | ¥10.72 |
DeepSeek V4 Pro 離峰 | ¥0.152 | ¥4.55 | ¥13.66 | ¥19.58 |
Grok 4.7(提示詞 <200k) | ¥3.35 | ¥13.4 | ¥40.2 | ¥83.75 |
Grok 4.7(提示詞 ≥200k) | ¥6.7 | ¥26.8 | ¥80.4 | ¥167.5 |
同用量=累計輸入 10M(快取命中 90%)+輸出 1M。DeepSeek 是官網美元價換算,離峰半價、尖峰全價;Grok 是 xAI 官網美元價換算。
三個要注意的:
小米沒有尖峰離峰:一口價,長排程的成本可預期;DeepSeek 一天差兩倍,排程踩到尖峰就翻倍。
Grok 的價格在 200k 提示詞這一刀直接砍成兩倍:輸入 $1→$2、快取 $0.5→$1、輸出 $6→$12,而且上下文只有 500k。跑大 context 的排程,帳單是 ¥167.5 不是 ¥83.75。
DeepSeek 離峰半價是真便宜,但它只在離峰;小米是隨時都是離峰價。而且便宜的窗口正是最擠的時候:2026/9/20 DeepSeek 年內至少第 18 次大面積異常,我自己一天被 503 幾十次、從台灣直連的探針三發全 200/0.5 秒(=崩的是大陸境內入口那段)。排程全排離峰,等於把重活塞進它最容易崩的時段。
同一把尺:每 1 分智商的成本
Artificial Analysis 的一題成本(benchmark 真實跑完的花費,含各家的快取與輸出長度):
模型 | 分數 | 每題成本 | 每分成本 | 速度 |
|---|---|---|---|---|
MiMo-V2.6-Pro | 46 | $0.13 | $0.0028 | 124.5 t/s |
Grok 4.7 (xhigh) | 46 | $3.74 | $0.0813 | 42.3 t/s |
DeepSeek V4.1 Flash(牌價) | 39 | $0.27 | $0.0069 | 190.1 t/s |
DeepSeek V4.1 Flash(離峰實付) | 39 | $0.127 | $0.0033 | 190.1 t/s |
DS 全家最高只有 39 分:V4.1 Flash (max) 39、V4 083f 36、V4 Flash 073f 34、V4 Pro 30;從 39 到 46 之間還夾著 GLM-5.3 45、Kimi K3 44、GLM-5.3-Flash 42、Gemini 3.8 Flash 41、Qwen3.8 兩顆各 40,一共 6 個模型。名次是第 13 對第 5、第 6:不是差一點,是差一階。
同分同尺,Grok 每分成本是小米的 28.8 倍,而且速度慢 2.9 倍。
官方並排表裡 Flash 也不差:Terminal Bench 4.0 Flash 28.8 對 DS V4.1 Flash 26.8、DeepSWE Flash 67.9 對 DS 74.2、AutomationBench Flash 52.3、JobBench Flash 61.2 對 DS 45.8:便宜那顆在通用任務上已經壓過 DS 的 Flash,而單價只有它的一半。
DeepSeek 離峰實付跟小米幾乎同價($0.127 vs $0.13),但少 7 分。
Grok 的輸出是 xhigh 想辦法給最多內容,verbosity 240M;小米 140M:長的輸出自己付錢。同一個問題在 DS 身上更明顯:V4.1 Flash 的 verbosity 250M 對上中位數 130M(+92%),單價便宜 3.3 倍、字數多吐九成,便宜的籌碼被自己的話量吃掉。
分數量不到「靠譜」,帳單與 503 量得到:DS 年內至少第 18 次大面積異常(2026/9/20,我一天 503 幾十次,但台灣直連探針三發全 200/0.5 秒:崩的是大陸境內入口)。AA 從 40 掉到 39 也不是退步,是 v4.3.2 換尺、Elo 錨點釘在 V4.1 Flash 自己身上。
這場評測本身也貴:MiMo 跑掉 $206.66,Grok 跑掉 $4,967.35,24 倍。
開源模型的王者:MiMo-V2.6-Pro 的 46 分是全榜開源第一名(第二名 GLM-5.3 45),官方原話就是 strongest open-source model to date。權重 MIT、HuggingFace 可下載,連 RL 的訓練環境與程式碼都開源。
註:AA 只有 Pro 的分數,沒有 MiMo-V2.6-Flash(首頁模型列表裡小米只列了 mimo-v2-6-pro,flash 頁 404)。Flash 要判斷強弱只能看兩個地方:官方 blog 的並排對照表,跟實測(下面那段)。另外 Pro-UltraSpeed 是第三顆:輸出 $8.7/百萬、宣稱 20 倍輸出速度,實時價正好是 Pro 的 10 倍:要快就得買單。
官方自己的說法就寫在 blog 上:「The MiMo-V2.6 series keeps the API pricing of the V2.5 series」:價格不動、分數往上,把智能/成本的 Pareto 往外推。這句話就是本文的立論:分數變便宜,不是變貴。
RL 訓練的帳也公開了:6 天內各跑 30 個 RL step、約 75 萬條軌跡,Flash 花 $0.85M、Pro 花 $2.62M,DeepSWE v1.1 從 48.8 拉到 65.68(Flash)、58.4 拉到 72.57(Pro):技術報告、訓練環境、RL 程式碼全部開源。
規格:拿什麼換的
小米那一邊的代價不是能力,是額度與規則(一手:[模型頁](https://mimo.mi.com/models/zh-CN/mimo-v2.6-flash)):
上下文 1M tokens、最大輸出 128K、RPM 100、TPM 10M:1M 比 Grok 的 500k 還長。(這是 Flash 的規格;Pro 也在 1M 這一級,AA 頁面同樣寫 1M。)
全模態輸入(文字/圖片/影片/音訊),支援工具呼叫、串流、聯網、結構化輸出、上下文快取。
模型授權 MIT,相容 OpenAI 與 Anthropic 兩種協議,換
base_url跟model就能搬。訂閱不是優惠:Token Plan Lite ¥39/月買到 4.1B credits,按 Pro 實時價算約 1,370 萬 tokens,跟按量計費同價:高用量想省錢要走批量 API(各檔打五折),不是訂閱。
三顆是一條線:
v2.6-flash(便宜那顆)、v2.6-pro(AA 46.32、開源最強)、v2.6-pro-ultraspeed(同品質、20 倍輸出速度、單價 10 倍)。還有mimo-v2.5-pro與mimo-v2.5已公告 2026-10-21 下線,要搬就現在搬。通路:官方 API、OpenRouter、
MiMo Desktop(同日從 early access 轉正式版,內建 Pro/Flash)。
快取命中率是真正的價差來源:小米那邊快取命中價是輸入價的 1/40($0.0028 vs $0.14),Grok 是 1/4;同一份長 prompt 重複送,兩邊的帳單差別比標價差別更誇張。
我怎麼實測的
把自己的 agent 主模型換成 mimo-v2.6-flash(provider xiaomi)跑了一整段工作,驗證點:
新對話的
sessions.model欄確實記成mimo-v2.6-flash,runtime 回報 provider 也是xiaomi:不是改到設定就算數,要拿到新 session 的資料庫欄位跟 runtime 回報才算生效。踩到兩個跟模型無關、但換模型一定會遇到的坑:桌面版會把「上次選的模型」存在 localStorage(
hermes.desktop.composer.model),新對話跟著它走、不看預設值;再來是模型可見性是一份白名單(hermes.desktop.visible-models),該廠商有存過清單之後,新推出的模型永遠不會自動出現,按「刷新模型」也沒用,得到「编辑模型…」把該 provider 的開關關掉再打開。純 API 對話沒問題;換模型的成本差異要等跑完一整段真實工作流才看得到。
我跑的是 Flash,沒有第三方分數可比,所以這段只能靠真實工作流判斷,不能拿 46 分當護照。46 分那張證書屬於 Pro。
實測:dsh-dock → 大飛 V4(Pilot Studio)
dsh-dock 移植到 Pilot Studio V4、打包、發佈這一整段,模型換成 MiMo 跑完,官網今天已經掛上👉 https://pilot.wow.to,版號 4.0.0-alpha.14(arm64 420 MB),新增 Computer Use 桌面操作、瀏覽器控制(直接開 Chrome 點按填表)、時光機(Turn Rewind,發訊前自動存 git 檢查點)、功能塢、用量記錄、模型餘額、開機自癒。
帳單(控制台一手截圖):
欄位 | 數值 |
|---|---|
歷史消耗 | 73,682,977 tokens |
輸入(命中快取) | 70,217,856 → 95.97% |
輸入(未命中) | 2,947,596 |
輸出 | 517,525 → 佔 0.70% |
批量推理 | 0(全程走實時) |
現算($0.0028/$0.14/$0.28 每百萬,Flash 實時)= $0.75;同一批數字走 DeepSeek V4.1 Flash 離峰= $0.96、尖峰= $1.92。帳上報的總額是 $0.9 美金(含其他步驟的口徑),量級對得上。
對照我自己 9/20 那篇的慘案:V2→V3 一兩億 token、一兩小時做完;V3→V4 十億 token、24 小時沒幹好。這次 V4 打包只用了 7,368 萬 token=那次的 7.4%,不到一塊美金,而且真的發佈了。
三個數字才是這段實測的重點:
96% 命中率:agent 反覆送同一份長上下文,命中價 $0.0028 對未命中 $0.14(1/50):前面說「快取命中是真正的價差來源」,這裡是實證
輸出只佔 0.70%:輸入對輸出 141:1,正好是 DS Flash verbosity 250M 那個病的反面
一口價:7,368 萬 token 全程沒有時段差異,排程不用看時間
API 申請
Key 與充值:
https://platform.xiaomimimo.com/#/console/api-keys、https://platform.xiaomimimo.com/#/console/balance(小米帳號登入,台灣海外充值走 waffo 收銀台,Apple Pay/Google Pay/信用卡皆可)基網址
https://api.xiaomimimo.com/v1,OpenAI 與 Anthropic 協議都收;GET /v1/models回 401 就代表端點活著。Grok 的 key 在
https://console.x.ai,美國區域,另加 10% 附加費。
結論
同一天發佈、同一把尺 46 分:Grok 4.7 每題 3.74 美元、42.3 t/s;MiMo V2.6 Pro 每題 0.13 美元、124.5 t/s:每分成本 29 倍,速度 2.9 倍
實際成本差在四件小事:Grok 200k 提示詞起全項目翻倍、DeepSeek 只有離峰半價且最擠的時段就是它最容易崩的時候(2026/9/20 我一天 503 幾十次)、verbosity 也是成本(DS Flash 250M 對中位數 130M、多吐 92%)、小米一口價且快取命中是輸入價的 1/40
大飛 V4(Pilot Studio)整個移植+打包+發佈用 MiMo 跑完:73,682,977 tokens、95.97% 快取命中、輸出只佔 0.70%,Flash 實時現算 $0.75(帳上 $0.9):上一次同樣規模的工程是用DeepSeek V4 Flash 花了十億 token、24 小時還沒幹好
DeepSeek V4 Flash 閒閒會突發503,沒事還會審查400,囉唆還產出不了,Mimo這次來得及時,站上了這個斬殺線的王者寶座。
買模型買的是每分智商的價格,不是分數本身。
౨ৎ Anthony 不負責任編輯 ~
留言 (0)