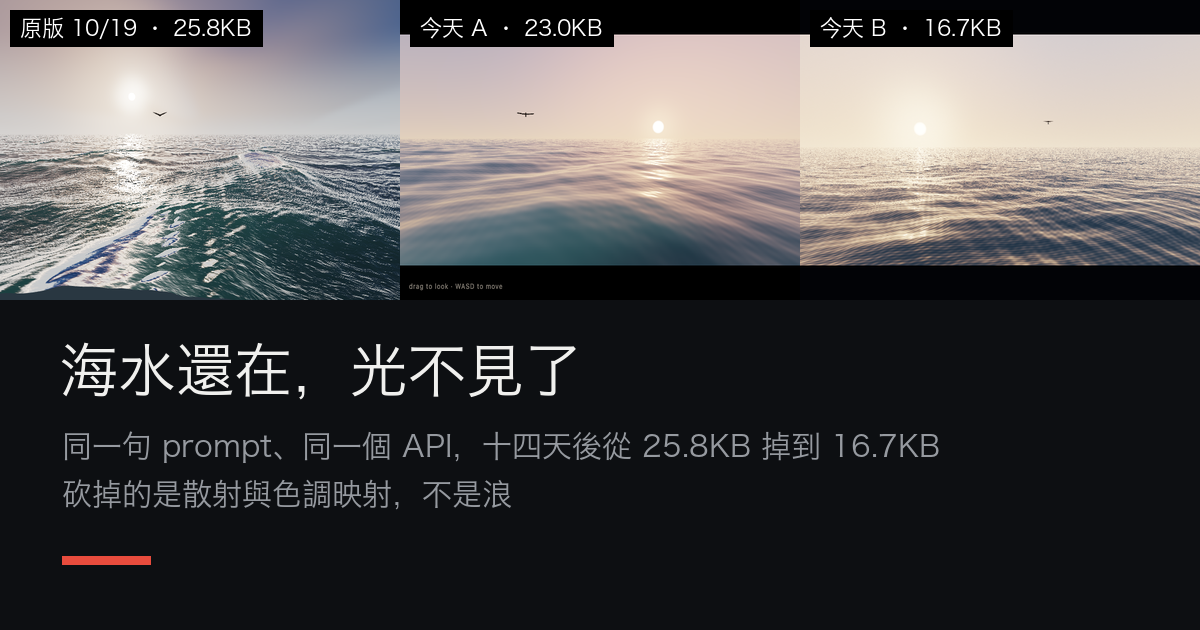
同一句 prompt,同一個 API,十四天。
10 月 19 日那顆 DeepSeek V4.1 Flash 1017,寫出一片 25.8KB 的海:大氣散射、ACES 色調映射、鏡面反光有 roll-off,浪尖不會糊成一片白。
今天我用一模一樣的句子再跑三次,最好的那次 23.0KB,最差的 16.7KB,第三次燒掉六萬四千顆 token、一個字都沒吐出來。
海水還在,光不見了。
我怎麼測的
Prompt 逐字照抄,包含那句「The feeling of 落霞與孤鶩齊飛,秋水共長天一色」與 one lone seabird,一行沒改。
條件是單發、無工具、不給它看截圖、不讓它迭代。今天三次都用 deepseek-flash,溫度預設,max_tokens 開到六萬四千。
這件事要先講清楚:原版那一次不是單發,是 10 月 19 日那個 session 裡的成品,中間有退版、有工具、有它自己看畫面。所以嚴格說這不是完整的 A/B,而是「一句話丟進去,它一次交出多少東西」對上「當年那個 session 最後留下的東西」。
能把話講死的是另一件事:今天三次的差異。
輸出 token | 耗時 | 檔案 | 行數 | JS 字元 | 完成原因 | |
|---|---|---|---|---|---|---|
原版 10/19 | 未記錄 | 未記錄 | 25,820 | 756 | 24,678 | 完成 |
A | 48,553 | 135 秒 | 23,006 | 862 | 21,722 | stop |
B | 47,837 | 177 秒 | 16,662 | 658 | 15,913 | stop |
C | 64,000 | 212 秒 | 0 | 1 | 0 | length |
A 與 B 的 token 幾乎一樣,48,553 對 47,837,差 1.5%。但成品一個 23.0KB、一個 16.7KB,差了 28%。同一個小時、同一個端點、同一句話,變異這麼大,這不是「模型笨」,這是「它在同一個預算裡選擇花在哪」。
【2026-11-03 更新】上面那三次測試跑在 18:08 到 18:16,落在這波異常開始之後。所以「同一小時內 23.0KB 與 16.7KB 差 28%」這個數字可能混到供應端降級,不完全是模型自己的選擇。要乾淨的對照,得等服務恢復後用同一份 prompt 重跑;這一段先標成未排除。
C 更直接。六萬四千顆 token 全燒完,finish_reason 是 length,輸出零字元。它把整個預算花在推理上,來不及寫第一行程式。
縮水的地方是光
我把三個檔案攤開比對。原版裡有三樣東西,今天兩版都沒有:
一個是大氣散射函式,天空與水面共用同一個計算。這正是「秋水共長天一色」能成立的原因,水裡的天不是調色盤調出來的,是同一道光算出來的。
第二個是 ACES 色調映射。它讓高動態範圍的亮部有 roll-off,太陽反光才會有層次,不會整片死白。
第三個是白沫的五處處理。今天 A 只剩兩處、B 剩四處。
原版:scattering 1、ACES 1、foam 5、reflect 2。 今天 A:scattering 0、ACES 0、foam 2、reflect 1。 今天 B:scattering 0、ACES 0、foam 4、reflect 1。
所以畫面差的不是浪。浪都還在算,A 的浪型甚至比原版更整齊。差的是光:沒有散射就沒有霧的層次,沒有 ACES 就沒有反光的形狀,水面變成一塊藍色漸層加規則條紋。
一句話:它先砍的是最貴的那一層。
這是三種不同的病
「降智」這個詞不夠精確,但那種一整天做不完活的感覺是真的。要修,得先分清是哪一種,因為三種病的修法完全不同。
第一種是輸出壓縮:結構完整、東西變薄。B 就是這個,658 行、16.7KB,該有的 function 都有,細節沒了。
第二種是推理失控:思考吃掉全部預算,成品零。C 就是這個,六萬四千顆 token、零字元、length。
第三種才是真的換了模型或降了精度:語法開始錯、概念跑掉、constraint 被忽略。
今天的樣本裡,前兩種都出現,第三種沒有。A 與 B 的 JavaScript 都通過 node --check,MSAA 與海鷗也在,說明程式沒有寫壞,只是寫得少。
別人也看到了
微博上一位「陈景天」昨天貼了對照測試:同一個提示詞,DeepSeek V4.1 Flash 剛更新時建模效果拉滿,兩週後輸出持續縮水,他懷疑自己「買到假 token」。528 個讚、193 則留言。
底下最高讚的回應只有一句:感覺每個模型都有經歷這樣一個衰退的過程。
這句話比任何 benchmark 都準。價格沒漲、版本號沒變、API 沒公告,但輸出變薄,而且薄的地方剛好是最花算力的地方。
對實際使用意味著什麼
先講還能不能用。A 版那片海是真的能跑:WebGPU adapter 拿得到、1280×633、MSAA 開著、海鷗在太陽左下,畫面在瀏覽器裡會動。它不是壞檔。
但它不再是 10 月 19 日那片海。
所以判準要改。以前看「有沒有產出」,現在要看「產出的密度」:同一個 prompt,記錄 token 數、成品大小、完成原因三樣。三樣裡只要有一樣不對(token 很多但成品很小、或 finish_reason 是 length),就是這一輪被砍了,重跑比修更快。
要它回到 10 月 19 日的水準,兩條路:把 effort 拉到 max,或者把重活丟給別顆。你付的是同樣的單價,換的是它願不願意花時間在一件事上。
同一天,服務又崩了
11 月 3 日北京時間 16:58,DeepSeek 官方狀態頁顯示網頁對話、V4 Pro API 與 V4.1 Flash API 部分中斷,到 17:06 仍在調查,之後公告已實施修復並持續監控。「DeepSeek 崩了」當晚上微博熱搜。
這不是第一次。10 月 15 日那次中斷五小時,官方補償方式是全額返還用戶七天內的消耗;媒體統計,2026 年以來至少 18 次大面積異常,平均每月一到兩次,業界普遍歸因於算力供需失衡。
我這邊當晚拿到的是 DeepSeek 自己吐的錯誤字串:Service is too busy. We advise users to temporarily switch to alternative LLM API service providers.(request_id: a4ed3c3e-7107-4cf9-8059-9d77cbaf2edd)同一時間、同一個模型,一個客戶端十分鐘沒有回應,另一個客戶端正常回話,差別就在服務端還有沒有空位。
官方的態度兩次不同。10 月 15 日那次有五小時中斷、正式道歉、七天全額返還;11 月 3 日這次,開放平台既沒有崩潰公告,也沒有補償,只有狀態頁留下一筆紀錄。中國社群已經把「短時間內的降智與崩潰」當成常態在使用,抱怨歸抱怨,沒有人期待官方表態。
更值得記的是使用者行為。有人在微博上算過,卡頓的時候反覆刷新會把請求量放大 27 倍,越急越難恢復。這跟我前面那組數字是同一件事的兩端:一千七百次呼叫、平均每次背 29.4 萬 token,那不是模型在想,是重試在滾雪球。
結論
同一句 prompt、同一個小時,三次的成品是 23.0KB、16.7KB、0;token 卻幾乎一樣。所以問題不在算力額度,在它把預算花在哪。
縮水的位置是可查的:散射函式沒了、ACES 色調映射沒了、白沫從五處剩兩處。砍掉的剛好是最花算力的那一層,所以海水變成藍色平面。
「降智」要拆成三種講:輸出壓縮、推理失控、模型降級。今天看到前兩種,第三種沒有;分得出來,才知道該重跑還是該換手。
十四天前那片海有光。今天同一句話,它決定把光省下來。這不是模型的錯,是有人在帳單上做了決定。
౨ৎ Anthony 不負責任編輯 ~
來源與方法
實測腳本與產出:ocean_ab.py,prompt 逐字照抄 2026 年 10 月 19 日那篇的內容,三次單發,模型 deepseek-flash,max_tokens 64,000,記錄 usage.completion_tokens 與 finish_reason。
原版檔案:https://anthony.apple.pro/ocean.html(25,820 bytes、756 行) A 版:23,006 bytes、862 行、48,553 tokens、135 秒 B 版:16,662 bytes、658 行、47,837 tokens、177 秒 C 版:0 bytes、64,000 tokens、finish_reason: length、212 秒
三版錄影對照:左為原版、中為 A、右為 B。
特徵比對(原始碼字串計數):原版 scattering 1、ACES 1、foam 5、reflect 2;A 版 scattering 0、ACES 0、foam 2、reflect 1;B 版 scattering 0、ACES 0、foam 4、reflect 1。
語法檢查:A、B 的 inline script 皆通過 node --check。
留言 (0)