六月,我寫了一篇「別再叫你老闆買 AI 主機」,用真實帳單算給大家看:30 億 token、台幣 1,000 元。頂規 Mac Studio 50 萬,除以每月 1,000,要 41 年才回本。誰買誰盤子。
八月十七日,DeepSeek 漲價。帳單從一千變三萬四,我連寫兩篇打自己臉的文章,然後默默把 M5 Max 放進購物車。
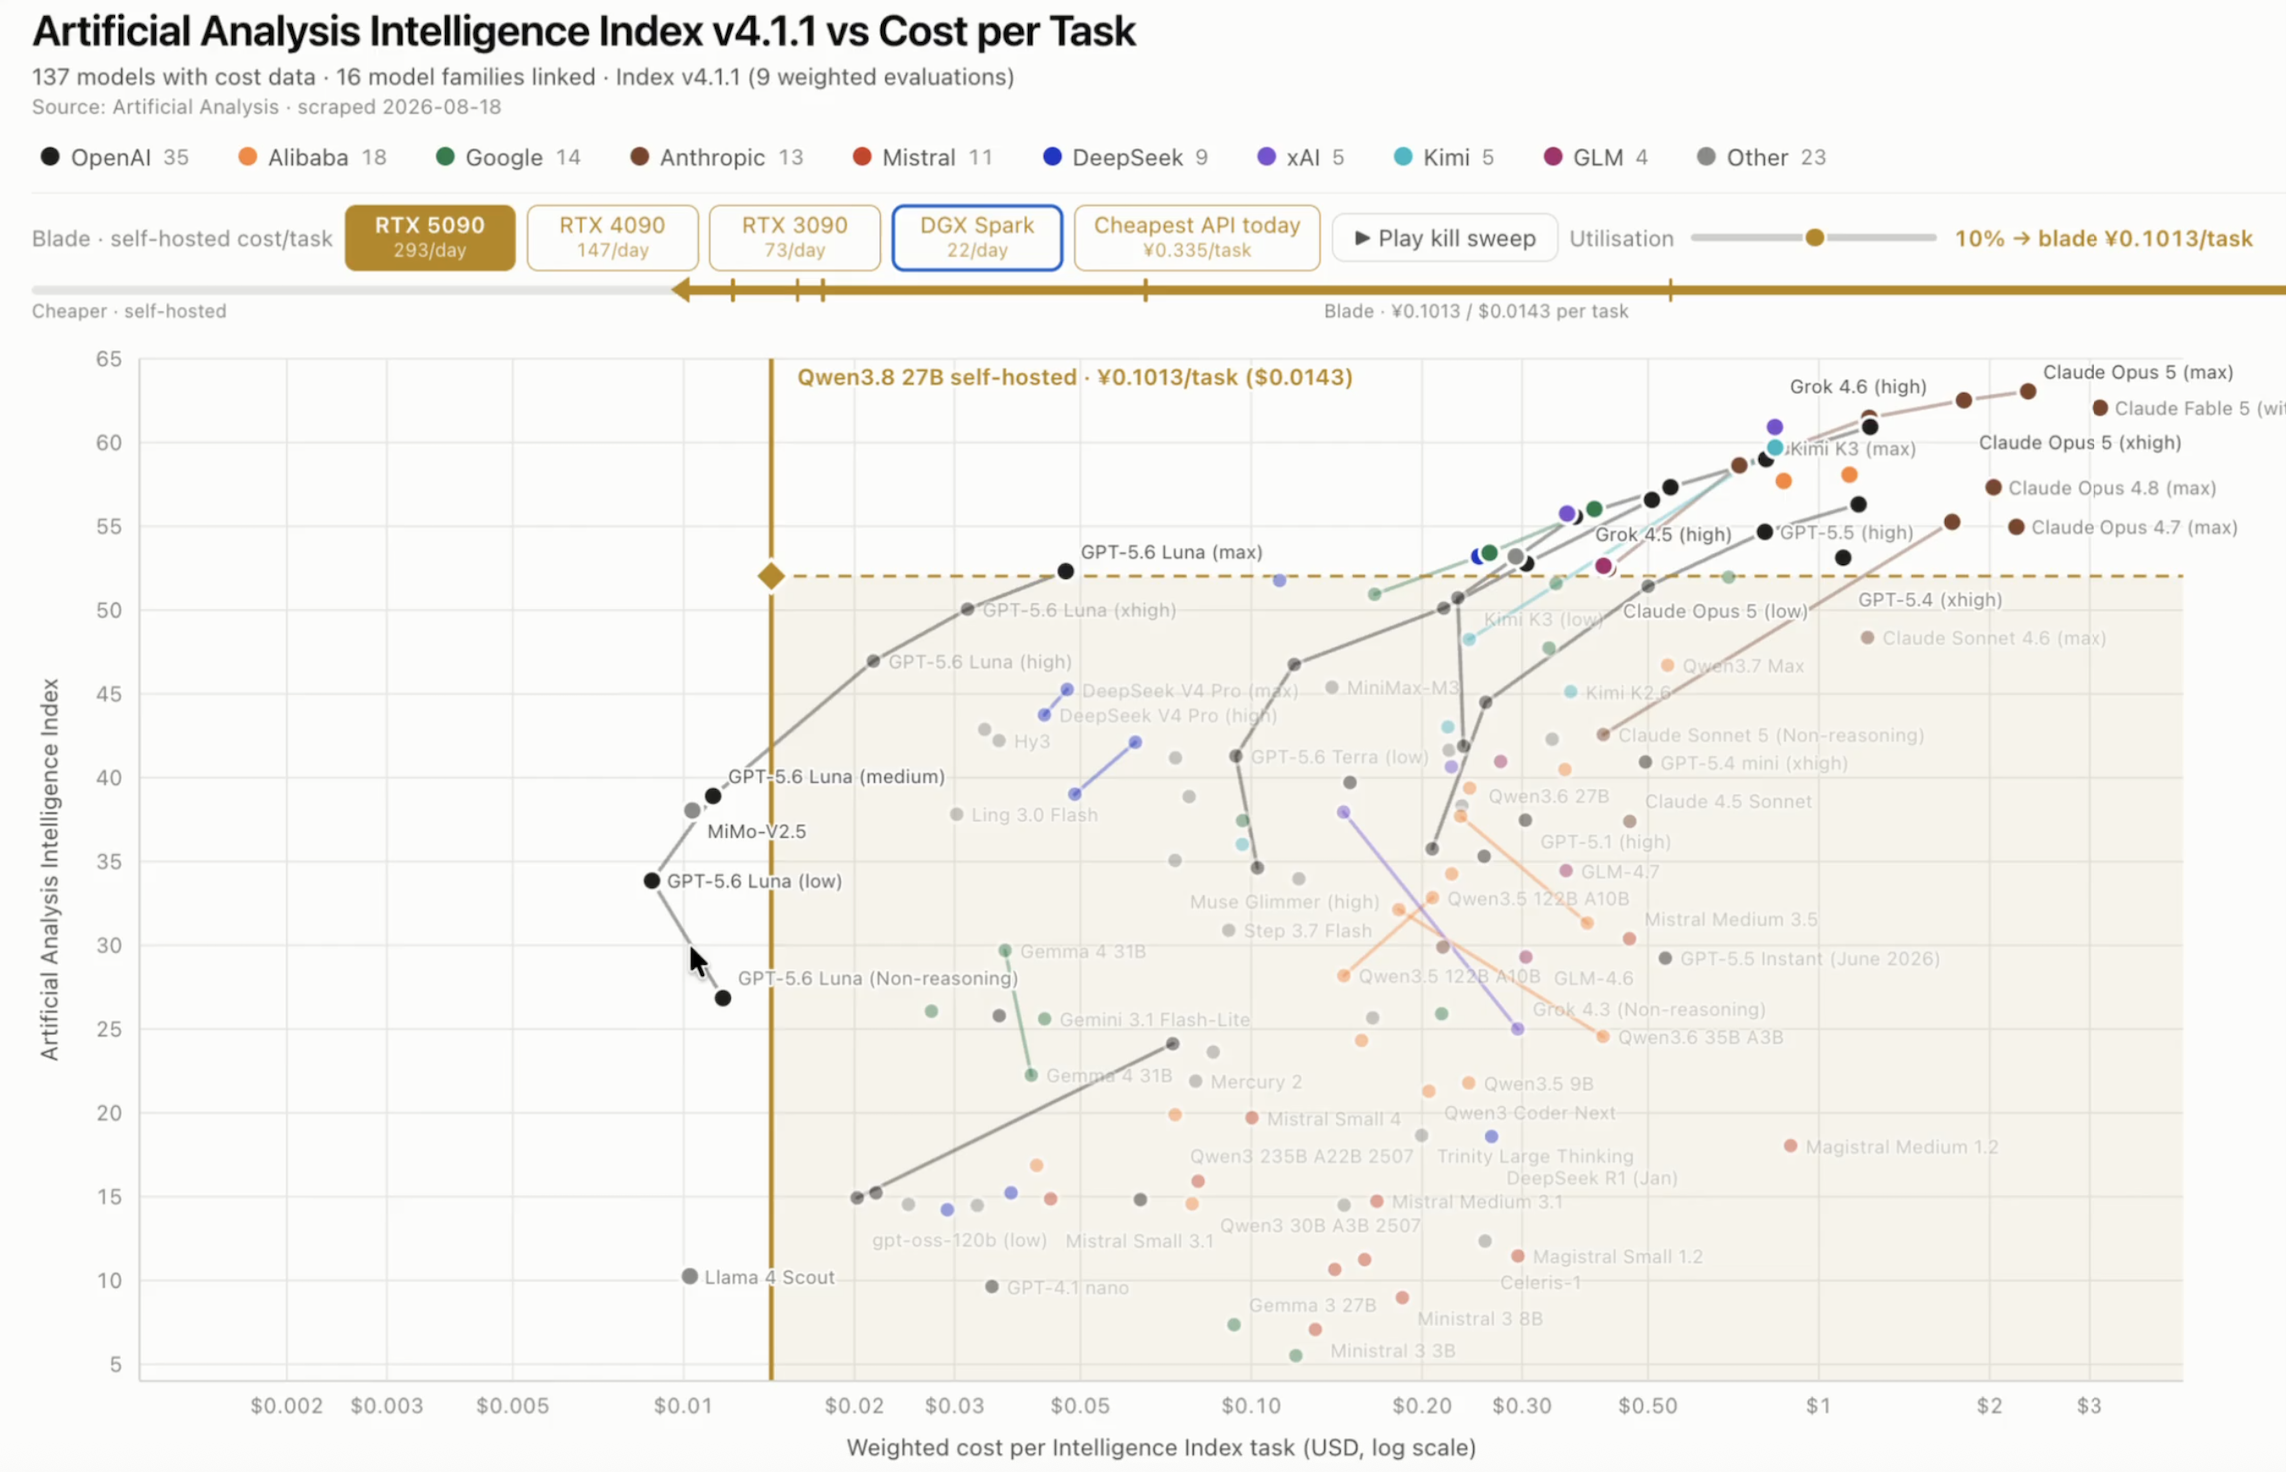
八月十九日,Artificial Analysis 那張 Intelligence Index v4.1.1 圖在網路上炸開——137 個模型攤在「智力分數 × 每 task 成本」的座標上,一條斬殺線傳瘋了。
三件事連在一起,我看懂了一件事:我被打臉,不是因為我算錯——是因為我活在舊的成本結構裡。而現在,這個結構正在被拆掉。這篇想講的,就是我從「被斬」到「看懂斬殺線」的過程。
先說我怎麼被斬的
(細節我寫過兩篇了,這裡只講重點。)
DeepSeek 的「峰谷定價」,說穿了就一句話:輸出漲最多,高峰輸出 4.5 倍、緩存命中輸入最高 +1100%。
而輸出偏偏是 agent 工作流唯一躲不掉的計價項——你讓 agent 寫 10 行程式碼,那 10 行就是輸出,沒有第二條路。
斬的是誰?持續消費的人。
AI 漫劇整排停更、淺層用戶退場、死忠用戶被逼著每按一次 Enter 都先問「值得嗎」。
活下來的是誰?資產型用戶。
我的教育刷題平台:1653 題大考真題,一次建好,學生刷一萬次,token 成本是零。
同樣的漲價,漫劇是每個月流血的傷口,題庫是躺著不動的資產。
我那兩篇的結論:重活躲高峰、輕活照做、本地推理終結輸出成本。
一台 M5 Max 128G,六個多月回本。
當時我心裡想的是:機器就是個帳單殺手。買了它,DeepSeek 就斬不到我了。
那條斬殺線
Artificial Analysis 那張圖:Y 軸智力分數、X 軸每 task 成本。
Qwen3.8-27B 自架在 RTX 5090 上,10% 利用率,成本 $0.0143/task,Intelligence Index 52 分——跟 GPT-5.6 Luna 同級,Apache 2.0 零授權費。
從這個點往右畫一條水平線:所有比它貴、智力又不比它高的模型,全部被一刀斬掉 👉 斬殺線。
社群炸了,很多人喊「奇點已到」。
但興奮歸興奮,有兩件事得先講清楚。
第一件:雲端不是全暴利。
$0.0143 是「硬體攤提+電費」,是材料費——麵粉、水、電,攤一攤就這些
雲端那 $0.3–$3 是餐廳價 —— 房租、廚師、洗碗、冷氣、店員全包在裡面,還有 7x24 運維、自動擴容、資安合規、SLA、客服。
拿自助餐的成本比餐廳菜單,宣布餐廳要倒,邏輯是壞的。
要比,比 TCO。
第二件:地端也沒那麼簡單。
一張 RTX 5090,台灣八月初大概 17 萬。
買回來之後呢?散熱規劃、575W 滿載功耗你家電路扛不扛得住、驅動相容性、推理引擎選型、量化格式(AD 量化)、KV cache 設定不對就 OOM、跑到一半 kernel panic 你查不查得出來。
社群裡 300+ 條實測貼文,多少人踩坑才跑起來的?
叫人無腦買機器的人,比賣 API 的更壞。
這句話我看了兩遍。
因為我八月那兩篇,其實就站在懸崖邊:我只算了回本,沒算坑。
本地對決:Qwen3.8-27B vs DeepSeek V4 Flash
斬殺線圖上,其實有兩個「地端選手」值得擺在一起看:Qwen3.8-27B 和 DeepSeek V4 Flash。一個 dense、一個 MoE,本地跑起來是兩套完全不同的經濟學。
項目 | Qwen3.8-27B | DeepSeek V4 Flash |
|---|---|---|
架構 | 27B dense(全量激活) | 284B MoE(每 token 激活 13B) |
Intelligence Index | 52 | 50 |
分/總參數 B | 1.93 | 0.18 |
分/激活 B | 1.93 | 3.85 |
最低硬體 | 單張 RTX 5090(32GB);24GB 的 4090 用 AD 量化也能跑(Top-1 97.3%) | 128GB 統一記憶體(M5 Max 等級)起跳 |
硬體成本 | 一張 5090 約 17 萬 (整台電腦當然不止) | M5 Max 128G 約 22.3 萬起 |
實測速度 | 4090 用 llama.cpp MTP 約 97 tok/s;5090 四人併發、每人 106 tok/s | M5 Max q2 量化:生成約 39 t/s、prefill 約 790 t/s |
第一眼會覺得 DS Flash 比較「划算」:每 token 只激活 13B,分/激活 B 3.85,是 Qwen 的兩倍 —— 每一分算力買到近兩倍的智力,這就是 MoE 的效率優勢。
但本地部署看的不是算力,是記憶體。
284B 參數得全部塞進記憶體才跑得起來,就算 q2 量化也要 70–90GB —— 這決定了它只能住在 128GB 的 Mac 或幾張卡串起來的機櫃裡。
而 Qwen 27B dense 雖然每 token 都激活全部參數,算力效率輸,但 24GB 就裝得下,一張 5090 插上去就跑。
用兩個指標看就很清楚:
分/總 B(決定你要花多少錢買記憶體):Qwen 1.93 vs Flash 0.18,差 10 倍。這一項 Qwen 完勝。
分/激活 B(決定每一秒的電費與速度):Qwen 1.93 vs Flash 3.85,Flash 近兩倍。這一項 Flash 贏。
翻譯成人話:DS Flash 是「跑起來很省」的模型,Qwen3.8-27B 是「買得起」的模型。
再往深一層看,這是兩種架構的設計哲學。
DS Flash 是雲端架構的王者:MoE 激活只有 13B,伺服器上每顆 GPU 能塞進最多用戶 —— 對雲端老闆是完美的成本結構,但那 284B 是有人替你扛的。
Qwen 是地端架構的王者:27B dense,為「一台機器一個人用」設計。
DS Flash 在雲端贏,Qwen 在本地贏,而斬殺線正好畫在兩者交界。
對中小企業來說,這是決定性的差異。
一張 5090、17 萬、單卡部署、不用跨卡——這是十人公司老闆點頭就能簽的預算;128GB 的 Mac 或幾張卡拼起來的機器,已經進入「要寫採購申請」的等級。
智力只差 2 分(52 vs 50),硬體門檻差一個量級 —— 這就是 Qwen3.8-27B 能被畫出斬殺線的原因:不是它最強,是它在「夠用」的智力水準上,第一次把硬體成本壓到中小企業伸手就夠得到的地方。
那 DS Flash 的舞台在哪?當你已經有 128GB 機器、需要長上下文、或追求單位算力效率時,它依然是好選擇。
我自己八月那篇的實測:M5 Max 128G 跑 DS V4 的 q2 量化版,生成約 39 t/s、prefill 約 790 t/s,輸出側一個月能扛 1–3 億 token,剛好吃掉 agent 帳單裡最貴的那塊輸出。
但那是「已經有機器的人」的選擇;對「從零開始的人」,Qwen3.8-27B 是門檻最低的那扇門。
線後面才是重點
斬殺線只是 2026-08-18 的一個 snapshot。
真正值得看的,是背後所有結構性力量都往同一個方向推:
開源模型四個月一代。
Qwen 3.6 到 3.8,四個多月,Intelligence Index 從 38 跳到 52,一代 +14 分,27B dense 第一次站到 frontier 門口。而且這不是偶然 —— Apache 2.0 放出來,讓社群壓測、量化、找問題,再吃回去當下一代訓練數據。社群不只是用戶,是免費的 QA 團隊。Serving framework 雨後春筍。
llama.cpp 的 MTP 讓 RTX 4090 從 45 飆到 97 tok/s;SGLang 在 5090 上四人併發、每人 106 tok/s;AtomicChat 的 AD 量化在 24GB VRAM 上跑出 97.3% Top-1。每個引擎的優化,都讓同一張卡更快,或讓更便宜的卡跑得動。Harness 層全面開源。
模型是嘴,harness 是手。過去這雙手只能借——Cloud Code、Codex、Cline,你用的是別人寫的 harness,改不了、帶不走。這個月 DeepSeek 把 DSH 完整開源,OpenClaw、Hermes、Pi、Maka 一整排選擇。嘴跟手,第一次都可以是你自己的。單位智力密度結構性暴漲。
用分/B 來看:Qwen3.8-27B 每 B 參數買到 1.93 分,Kimi K3 只有 0.02——差 90 倍。上一代 Qwen3.6-27B 約 1.41,一代之間密度提升 37%。如果這個速度持續,兩三代之後同樣的 27B 參數量能做到什麼水準?
這些力量合在一起,不是「進步一點」,是單位智力成本正在結構性崩盤。
同一條長思維鏈,兩種經濟學
整件事裡,我覺得最深的觀察是這個。
評測紀錄顯示,Qwen3.8-27B 在評測中總共生成了 1.6 億 tokens,所有受測模型的中位數只有 4300 萬。
它用將近 4 倍的推理量——更長的思維鏈、更多的搜索與驗證——去補參數量不足的劣勢。
關鍵在成本結構:
在雲端,想得更用力 = 生成更多 token = 帳單更高。
長思維鏈是成本放大器。不是雲端模型不會思考,是每一次思考都在燒你的錢,所以企業只敢在最高價值的任務上讓它想久一點。在本地,想得更用力 = 多花一點電和時間。
硬體是買斷的,token 成本接近零。長思維鏈是免費的智力放大器。
同一個機制,兩種成本結構,產生完全相反的經濟效應。
開源地端模型天生就適合靠推理時間換品質——「以時間換取智力」。
這順便升級了我八月的結論。我那時候只把機器當帳單殺手,現在我懂了:機器不只是省錢的工具,它是免費的智力放大器。
雲端模型想 10 秒就開始燒錢,我的模型可以想 10 分鐘——只要電費。
一台 27B 的小模型,可以用奢侈的思考量去跟雲端巨頭在特定任務上扳手腕。
這是地端模型彎道超車的核心武器。
杰文斯悖論:省下來的智力,不會被存起來
1866 年,英國經濟學家杰文斯翻帳本發現一件事:蒸汽機越省煤,英國的煤消耗反而翻著倍漲。因為煤一便宜,紡織廠用得起了、鐵路用得起了、輪船用得起了,最後連家裡燒熱水都用得起了 —— 每一分省下來的成本,都被新冒出來的用途吃回去,還不夠吃。
智力正在走同一條路。
今天 frontier 雲端模型 $0.3–$3/task,所以只有最高價值的任務才配用:寫程式、做研報、跑量化策略。絕大多數日常任務請不起頂級模型。
但當 $0.014/task 就能買到 52 分的模型時,一整層「過去不值得用 AI」的任務被解鎖了:
逐條比對那份 200 頁的政府採購規格書
讀懂公司跑了十五年、沒人敢重構的 legacy 系統
每天三百封客服信件的分類與情緒分析
這些事從來不缺方案,缺的是「值得為它花那個腦子」的經濟條件。現在條件成立了。
而且這跟我那兩篇的「資產型用戶」是同一枚硬幣的兩面:價格上漲時,資產型用戶免疫;價格崩盤時,杰文斯悖論讓長尾任務全數解鎖——而能把便宜的智力變成資產的人,會是最大的贏家。漫劇在燒錢,題庫在躺賺,差別不在模型,在用法。
五道門檻同時倒,最後一哩路是 Killer App
把這件事攤開看,Qwen3.8-27B 做了一件過去沒有任何單一模型做到的事——把中小企業部署 AI 的五道門檻一次性拆掉。
資安:Apache 2.0,模型跑在自己機器上,資料不出公司。受監管行業(醫療、金融、法律、政府標案)直接從「不能用 AI」變「可以用 AI」。
性價比:$0.014/task、52 分,大量日常任務根本不需要 Sota。
智力水準:跟 GPT-5.6 Luna 同級,不是玩具,是真的能幹活的等級。
硬體價格:一張 5090、17 萬,一間十人公司付得起,不用機房、不用年約。
部署門檻:27B dense 單卡就裝得下,不用跨卡、不用 NVLink、不用 tensor parallelism,插上去就跑。跟 DS Flash 這種 284B MoE 比,你要嘛有 128GB 機器、要嘛組多卡——複雜度差了一個量級。
大家都說五道門檻同時倒。我想補第六道:對重度用戶來說,還有一道「持續消費 vs 買斷」——而這道,正是斬我的那把刀。
那現在缺什麼?缺 Killer AI App。
基礎設施已經就位:模型有了、成本降了、harness 開源了。但中小企業不會因為「AI 便宜了」就自動導入——他們需要看到一個具體場景、一個真實痛點、一個可量化的回報。
這也意味著一個全新的商業機會:AI System Integrator。
未來的 ToB 生意不是轉賣 API,是替中小企業「踩坑」——把開源模型、開源 harness(DSH、Hermes)、消費級 GPU 打包成開箱即用的地端 AI 方案。
散熱、驅動、量化、KV cache 這些坑,未來都會是別人的服務費。
結論
Qwen3.8-27B: 52 分的 27B 地端王,$0.014/task、Apache 2.0、24GB 顯卡就能跑——買斷智力的門檻第一次低到伸手就摸得到
DS V4 Flash: 參數效率 3.85 全場最強,但那是雲端王的優勢——284B 自己扛要 q2 量化加 39 t/s,地端性價比輸 Qwen 一個量級
真正的重點: 買不買根本不是重點 —— 重點是你打算用這些便宜的智力,做什麼資產
斬殺線斬的不是雲端,是「持續消費」。
買斷智力的人,這次終於站在線的這一邊。
最後:那算力中心呢?
整篇都在講「個人跟中小企業買機器」。但這條斬殺線其實還有一刀,我沒砍下去:算力中心。
當 27B 的地端模型在「夠用」的智力水準上逼近 frontier,當一台 17 萬的 5090 就能扛住一間公司大半的日常任務——那雲端大廠幾百億砸出來的 GPU 資料中心,到底在為哪些任務服務?
這個話題牽動的層面很大:H100 等級的軍備競賽、資料中心的電力與散熱、模型廠商整個商業模式的重組。數據我還在整理,下一篇再展開。
先留一句話:當智力從「租」變成「買」,賣智力的生意,遲早要換一種賣法。
P.S. 誠實註腳:這篇的數據來源都是公開資料——Artificial Analysis 的 Intelligence Index、社群實測貼文,以及我自己前兩篇的實測。我八月說的「機器六個多月回本」到現在依然成立,但要提醒的是:回本數字是「替代的那部分帳單」算出來的,坑的成本還沒算進去——散熱、保固、kernel panic 的週末。買之前,先想清楚誰來踩這些坑。
還有:六月我說別買Mac,八月我勸大家去訂,今天又多了一個買的理由。
梁文峰繼續幫蘋果賣Mac,阿里幫 NVIDIA 賣顯卡 👉 大頭們都開心,只有我們的帳單不開心。
౨ৎ Anthony 不負責任編輯 ~
留言 (0)